
医渡科技新一代AI Native科研平台,开启AI for Science临床科研新实践
人工智能正在成为基础科研不可或缺的能力,AI for Science(AI4Sci)作为继实验科学、理论科学、计算科学之后的第四科研范式,正在重塑从假设提出到成果验证的完整链路,而医学科研被认为是AI4Sci落地迫切、具有较大想象空间的场景。
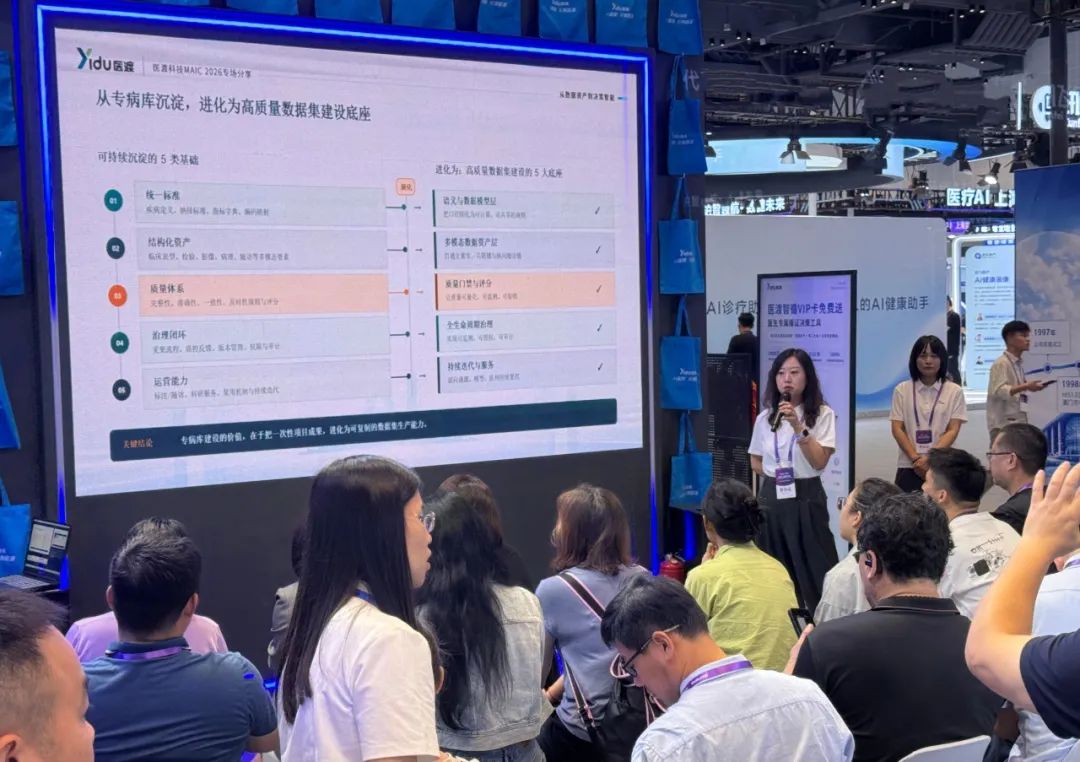
近日,在MAIC2026第二届医学人工智能大会医渡科技专场分享会上,医渡科技科研业务高级产品总监李冰带来《医渡智研:新一代AI Native科研平台》主题分享。在她看来,临床科研产品正从数据平台、Workflow AI迈向多智能体协同的Agent Platform,终局是一个以高质量医学数据为基础、以科研Agent为核心驱动的AI Native Research OS,让AI真正参与科研全过程,把医生的精力释放到科学问题本身。
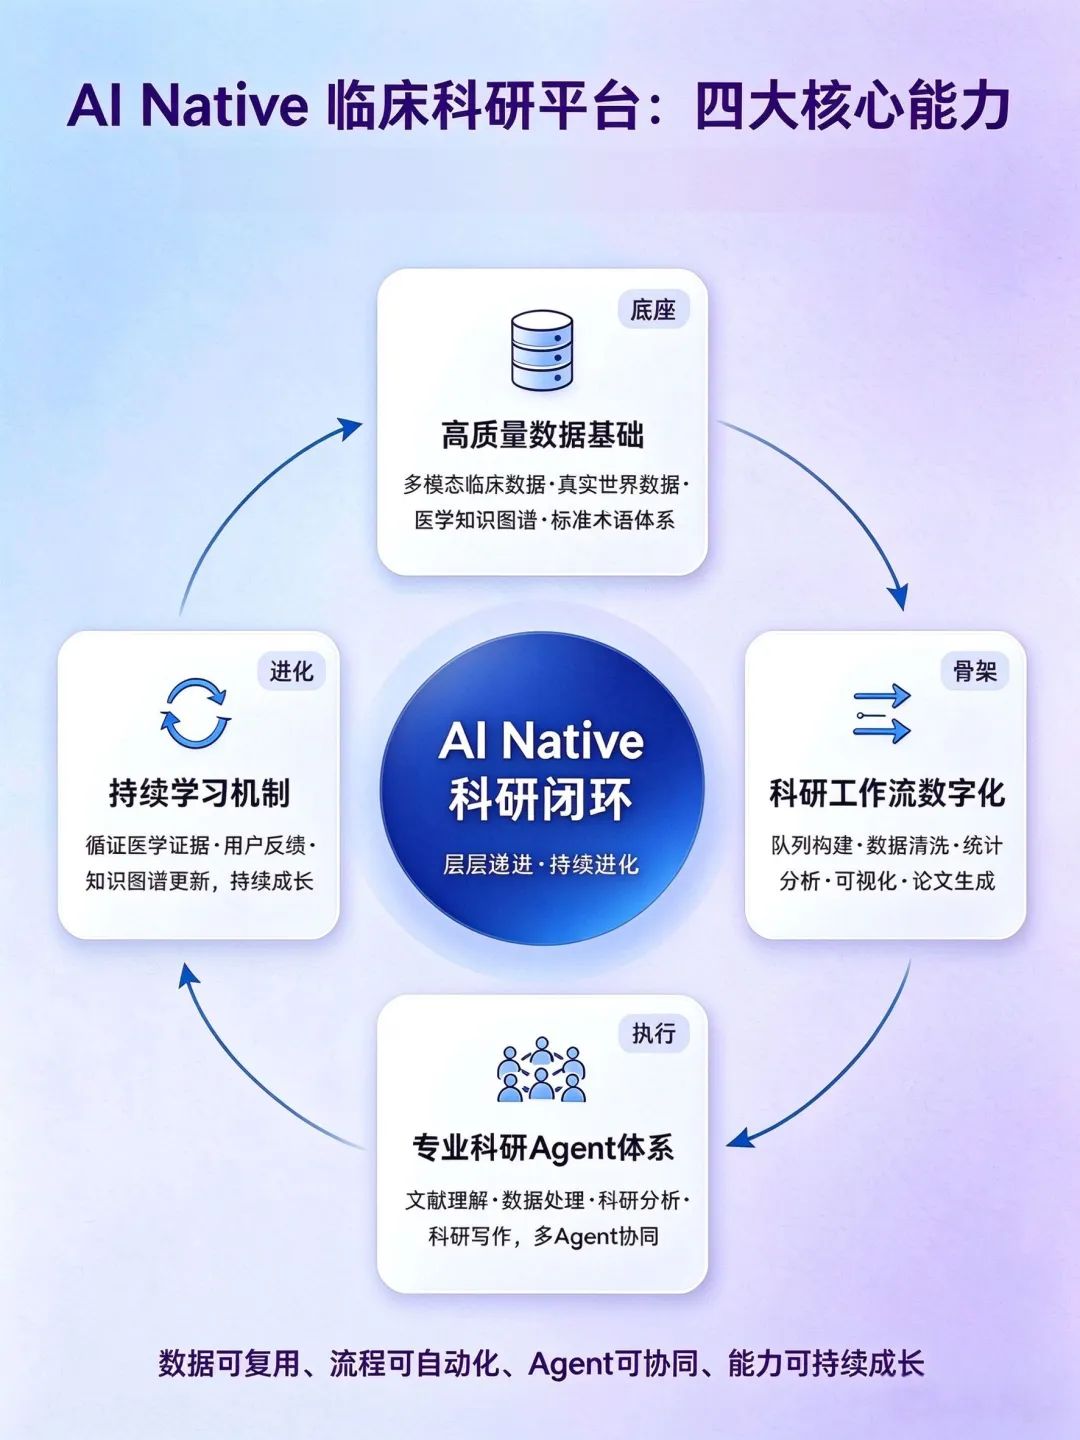
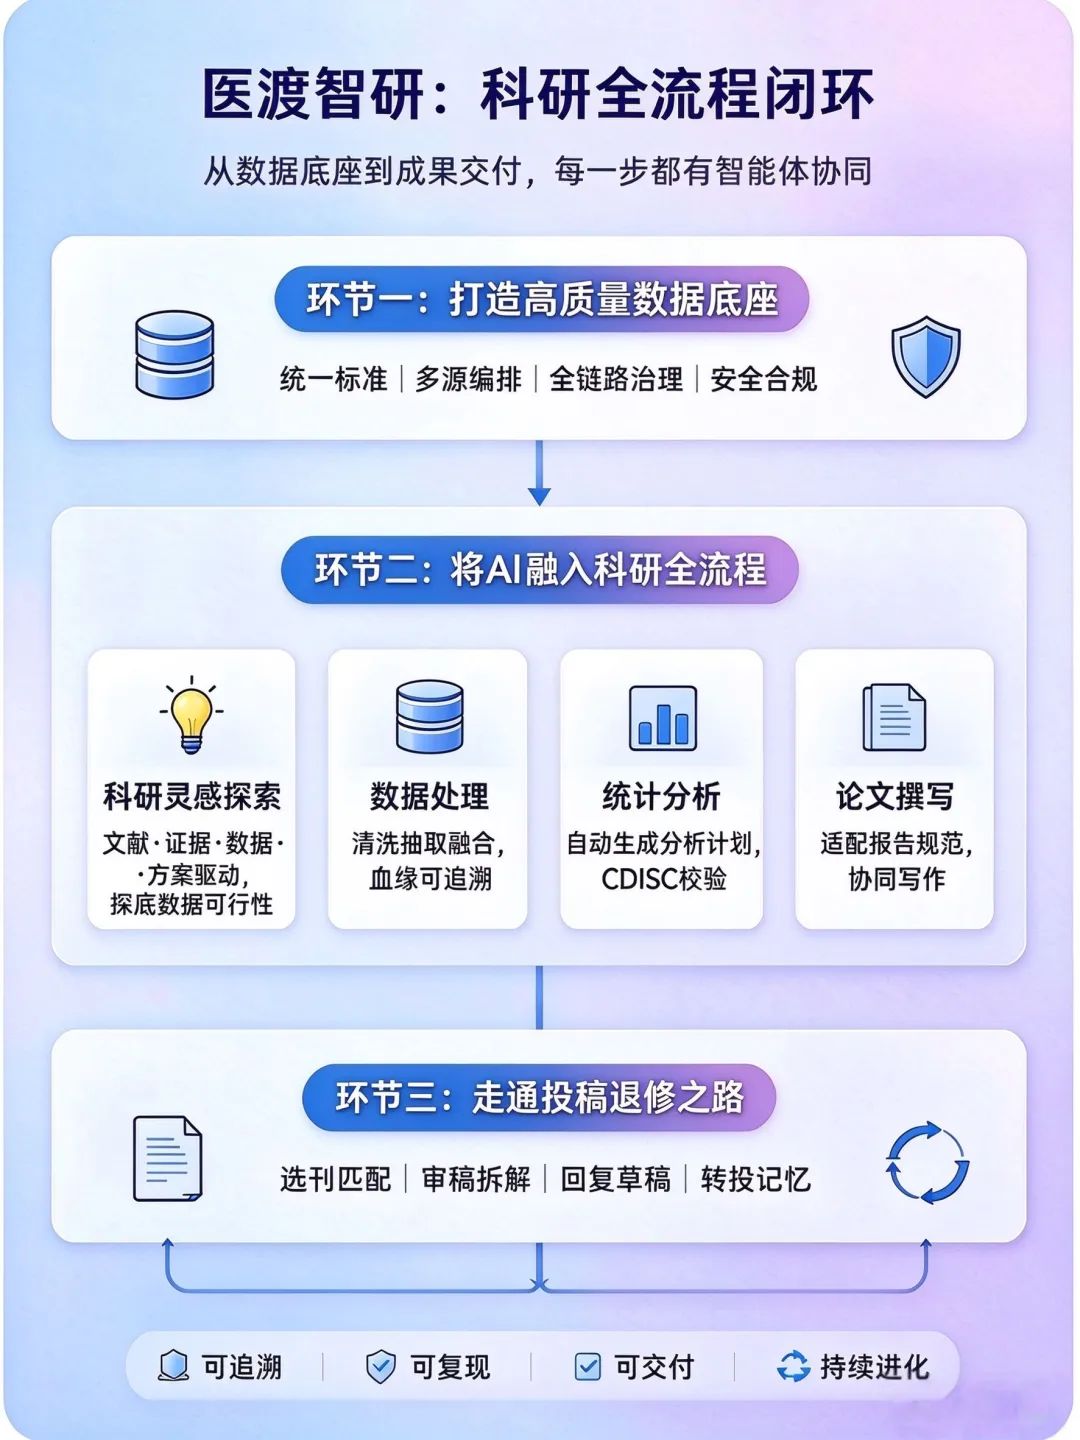
AI Native 临床科研产品核心能力应该有哪些? 回答“如何落地”,先要厘清一个前提:到底什么才算真正的AI Native临床科研产品。 优秀的AI Native科研产品,不是给旧系统加一个聊天框,而是把研究者的科研意图,转化成可执行、可验证、可复用的完整科研闭环,李冰表示,临床科研数字化已走过工具化、平台化、智能化三个阶段,如今正迈向AI Native(Agent、Research OS)的第四阶段——AI不再只是回答问题,而是协同完成从研究设想到成果产出的完整任务。这一阶段的跃迁,恰好与AI4Sci从“辅助计算工具”走向“自主科研主体”的行业大势同频。 李冰认为未来AI Native临床科研平台需要具备四个核心能力: 第一、高质量数据基础。包括多模态临床数据、真实世界数据、医学知识图谱以及标准术语体系,这是所有AI能力的基础。 第二、科研工作流数字化。将队列构建、数据清洗、统计分析、可视化以及论文生成等流程全部实现标准化和自动化。 第三、专业科研Agent体系。不同Agent分别负责文献理解、数据处理、科研分析、科研写作等任务,并通过多Agent协同完成复杂科研工作。 第四、持续学习机制。平台能够根据新的循证医学证据、用户反馈以及知识图谱不断更新模型能力,使AI持续成长,而不是一次性的工具。 这四项能力层层递进——数据是底座,流程是骨架,Agent是执行,学习是进化,共同指向一个判断:AI Native科研产品的关键,不在于模型参数更大,而在于数据可复用、流程可自动化、Agent可协同、能力可持续成长。这与 AI4Sci所追求的“让机器承担可形式化的科研劳动、让人聚焦科学判断”一脉相承,也是医渡智研区别于一般对话式AI工具的根本所在。 让数据“活”起来,让研究跑下去 医渡智研的落地答卷 正是按照这样一套能力框架,医渡科技打造了新一代AI Native科研平台——医渡智研。李冰介绍,医渡智研以“把研究者的科研意图,转化为可执行、可验证、可复用的完整科研闭环”为目标,让AI从“问一句”走向“做完一项研究”,助力医院将沉淀多年的数据资产,转化为可落地的决策智能。 从架构上看,医渡智研覆盖客户产品层、领域应用与流程层、共性智能能力层、模型服务与智能编排层、数据与AI基础平台层以及安全合规与基础设施层,形成从数据到应用的完整体系。 沿着临床科研真实的工作链条,医渡智研把数据、选题、统计、写作、投稿各个环节贯通起来,而这一落地路径,可以概括为三个相互衔接的环节: 一、打造高质量数据底座。 对AI4Sci而言,高质量、可治理、可复用的数据底座,本身就是科研生产力的核心基础设施。医渡科技多年专病库建设的经验,被凝练成一套高质量数据集底座:统一标准固化疾病定义、纳排规则与指标字典,沉淀临床、影像、病理、随访多模态资产,建立可量化的数据质量评价体系,形成全生命周期治理闭环,让数据从一次性消耗品,变成能反复为不同课题供数的源头活水。 在这一底座之上,生长出两大面向客户的平台:临床科研全流程平台 Research OS,覆盖研究设计到成果产出全过程;医疗高质量数据集生产平台 Medical Data Factory,完成原始数据到可交付产品的全链路加工。权限、脱敏、隐私计算、审计、访问审批、等保合规、容灾备份等安全能力贯穿全链。 二、把AI装进科研的每一个环节。 科研灵感探索智能体以文献、证据、数据、方案四类驱动推进:扫描领域热点、锁定方向、拆解核心文献,并在方案成形前对接院内数据库“探底”样本量、字段填充率与随访条件,从源头回答“这个课题,数据到底能不能做”。 数据环节,处理智能体完成数据理解、清洗标准化、多模态抽取、融合交付,关键节点交由研究者确认,留存处理脚本、质量报告与数据血缘,把原始病历加工成可信、可复用的科研资产。 统计与论文环节,统计分析智能体自动生成分析计划、覆盖常规统计、因果推断、自动化建模等多元场景,让“方法选择-可信执行-结果交付”成为可复现闭环;论文撰写智能体依据不同研究范式,适配多款国际报告规范,多模块协同写作并做全文一致性核查。 三、把投稿返修这条路走通。 投稿返修智能体围绕“提升命中率、降低遗漏与冲突” 展开:投前结合文章特点匹配目标期刊、评估投稿风险并适配材料格式;返修阶段逐条拆解审稿意见、制定修订策略并生成回复草稿,同时做全文一致性核查。 依托项目记忆能力,即便转投也能完整保留文章画像、期刊约束与版本记录,让前一轮审稿的价值不被浪费,把选刊、投稿、返修、转投串成一条连续不中断的交付链路。 AI Native科研平台的壁垒在于研究任务更懂、证据更稳、执行更可交付,每一步都要可追溯、可验证、可负责——这正是医渡智研把证据链、数据安全和人机协同放在首位的原因。 从数据资产到决策智能,医渡智研的探索指向的是临床科研分工的一次重构:AI负责流程性、重复性、校验性的工作,医生负责临床洞察与科学判断。当AI深度嵌入科研全流程,临床医生的核心价值,将更多回归到那个最本源的命题上——发现真问题,提出好假设。